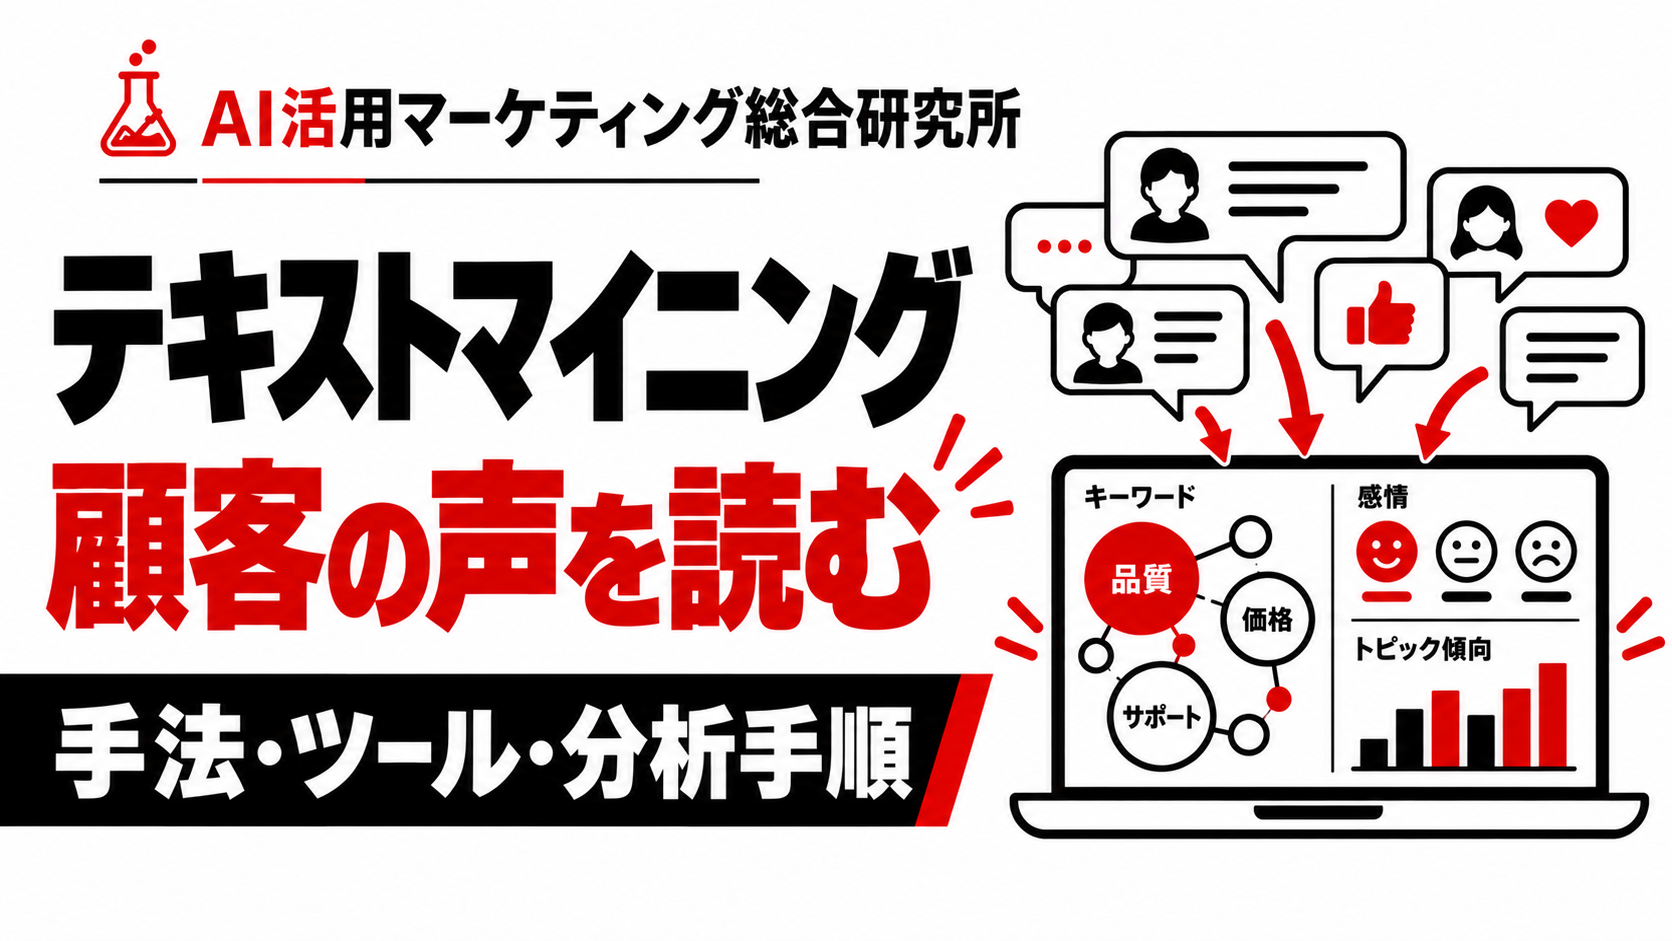
テキストマイニングとは、アンケート、口コミ、問い合わせ、SNS、商談メモなどの文章から、頻出語、組み合わせ、感情、話題、変化を抽出し、意思決定に使える形へ整理する方法です。単語を数えるだけではなく、「誰の、どの場面の、何を改善するために読むか」を決めることが成果を左右します。
この記事では、テキストマイニングの意味、代表的な手法、無料で始める方法、生成AIとの違い、ツール選定、実務の分析手順まで解説します。実際の顧客データを使う前に必要な匿名化、サンプリング、評価、誤解しやすいポイントもまとめました。
- 目的と意思決定を先に決め、必要な文章だけを集めます。
- 頻度、共起、分類、感情、時系列を目的に応じて組み合わせます。
- 生成AIの要約だけで結論を出さず、原文と集計へ戻ります。
- 個人情報、偏り、少数意見、文脈の欠落を確認します。
- 分析結果を施策、担当者、期限、再測定へつなげます。
目的やデータを入力し、比較・導入前に確認すべき条件を表にします。
ChatGPTで条件を整理する個人情報・顧客情報・未公開情報は入力せず、料金・仕様・制度は公式情報で再確認してください。
- テキストマイニングとは?
- テキストマイニングでできること
- テキストマイニングの代表的な手法
- テキストマイニングのやり方7ステップ
- 無料でテキストマイニングを始める方法
- テキストマイニングツールの選び方
- 生成AIでテキストマイニングする方法
- マーケティングでの活用例
- テキストマイニングの注意点
- テキストマイニングを始めるためのサンプル設計
- 分類辞書を作る方法
- 分析精度を評価する指標
- 頻出語・共起・感情分析の使い分け
- 生成AIを組み合わせるときの役割分担
- ダッシュボードに載せる指標
- 分析から改善施策へつなげる会議
- よくある失敗と修正方法
- 30日間の導入ロードマップ
- 業界別の活用例
- 無料ツールと有料ツールの判断
- 分析レポートのテンプレート
- データ品質を保つ運用ルール
- 小さく始めるための最初の100件
- 結果を公開するときの注意
- アンケート設計から改善する
- 時系列比較の注意点
- 分析担当者の役割分担
- 成果を判断する基準
- よくある質問
- 参考資料と関連記事
テキストマイニングとは?
文章を定量・定性の両面から読む方法
テキストマイニングは、大量の文章を単語や文へ分け、出現回数、同時に使われる語、分類、感情、話題などを調べる方法です。数値データだけでは分からない「なぜ満足したか」「どこで迷ったか」「何を改善してほしいか」を把握する助けになります。
自然言語処理・生成AIとの違い
自然言語処理は、文章をコンピュータで扱う広い技術領域です。テキストマイニングは、その技術や統計を使って文章から傾向を発見する実務です。生成AIは、分類、要約、仮説づくりを支援できますが、同じ指示でも回答が変わることがあり、母数や再現性の確認が必要です。
アクセス解析との違い
アクセス解析では、流入、閲覧、クリック、CVなど行動を測ります。テキストマイニングでは、問い合わせ理由、口コミ、検索語、自由記述など、行動の背景にある言葉を読みます。両方を結び付けると、離脱率が高いページで顧客が何に迷っているかを検討できます。
| 方法 | 主なデータ | 分かること | 注意点 |
|---|---|---|---|
| アクセス解析 | PV、クリック、CV | どこで行動したか | 理由は推測になりやすい |
| アンケート集計 | 選択肢、点数 | 満足度や割合 | 選択肢にない理由が抜ける |
| テキストマイニング | 自由記述、口コミ | 話題、理由、表現 | 文脈と偏りを確認する |
| 生成AI要約 | 入力した文章 | 概要、分類候補 | 再現性と根拠確認が必要 |
テキストマイニングでできること
顧客ニーズと不満の把握
問い合わせや口コミから、価格、品質、配送、操作、サポートなどの話題を分類します。件数だけでなく、どの顧客層、商品、時期で増えたかを見ます。
商品・サービス改善
要望を機能単位へ分け、頻度、重要度、実現難易度を整理します。声が大きい少数意見と、件数は少なくても重大な安全問題を同じ基準で扱わないことが重要です。
FAQ・コンテンツ企画
問い合わせで繰り返される質問をFAQへ反映し、検索語や営業メモと合わせて記事テーマを決めます。頻出語をそのまま見出しへ入れるだけでなく、読者が最終的に何を判断したいかを考えます。
ブランド・評判の観測
SNSやレビューから、肯定・否定の変化、話題の急増、競合との比較表現を確認します。投稿者の属性、皮肉、引用、キャンペーンの影響を考慮し、感情スコアだけで断定しません。
営業・コールセンターの改善
失注理由、断り文句、問い合わせカテゴリ、エスカレーション理由を分類します。担当者評価へ直接使う前に、案件難易度や記録ルールの差を調整します。
テキストマイニングの代表的な手法
頻出語分析
単語の出現回数を数えます。全体像を把握しやすい一方、「商品」「サービス」のような一般語が上位になるため、不要語、表記揺れ、品詞を調整します。
共起分析
同じ文章や近い範囲で一緒に現れる語を調べます。「価格」と「高い」、「設定」と「難しい」のような関係を見つけます。共起は因果関係を意味しないため、原文へ戻ります。
感情分析
肯定、否定、中立や、喜び、怒り、不安などを分類します。日本語の否定、皮肉、文脈、業界用語で誤判定が起きます。重要な用途では人がサンプルを確認します。
トピック分類・クラスタリング
文章を問い合わせ、配送、価格、機能などへ分けます。あらかじめ分類を決める教師ありの方法と、似た文章をまとめて話題を探す方法があります。分類基準と例外ルールを文書化します。
時系列・属性別分析
月、商品、地域、顧客層、チャネルで変化を比較します。全体で増えた語が、単に回答数の増加によるものか、割合も増えたのかを区別します。
| 手法 | 向いている問い | 出力例 | 誤解しやすい点 |
|---|---|---|---|
| 頻出語 | 何が多いか | 単語と件数 | 重要度とは限らない |
| 共起 | 何と何が語られるか | ネットワーク | 因果関係ではない |
| 感情 | 肯定・否定の傾向 | 割合、時系列 | 皮肉や否定に弱い |
| 分類 | 問い合わせを分けたい | カテゴリ別件数 | 分類基準が結果を左右 |
| 要約 | 大量の原文を把握したい | 要点、代表例 | 少数意見が消える |
テキストマイニングのやり方7ステップ
1.意思決定を一文にする
「顧客の声を分析する」では広すぎます。「解約理由を上位5カテゴリへ分け、来月の改善担当を決める」のように、分析後の行動まで書きます。
2.対象データと期間を決める
アンケート、口コミ、問い合わせ、商談メモなどを選びます。取得方法や時期が違うデータを混ぜると、件数の差をそのまま比較できません。
3.個人情報と不要情報を除く
氏名、連絡先、住所、注文番号、健康情報などを必要に応じて削除・置換します。分析目的、利用権限、保存期間、削除手順を決めます。
4.表記を整える
全角・半角、表記揺れ、同義語、誤字、絵文字を扱います。ただし、過度な正規化で顧客特有の表現を消さないよう、元データを保持します。
5.分析方法を選ぶ
最初は頻出語とカテゴリ別件数で全体を見て、必要に応じて共起、感情、時系列へ進みます。高度なモデルを使うことより、問いに合う方法を選びます。
6.サンプル原文へ戻る
上位カテゴリごとに代表例、例外、反対意見を読みます。自動分類の正誤をサンプルで確認し、分類基準を修正します。
7.施策と再測定を決める
改善内容、担当者、期限、期待する変化、再分析日を決めます。レポートを作って終わりにせず、次の観測条件を残します。
分析設計テンプレート
目的:解約理由を特定し、改善優先順位を決める
対象:直近3カ月の解約アンケート自由記述
除外:個人名、連絡先、注文番号
分類:価格、機能、操作、サポート、競合、その他
確認:各カテゴリから20件を人が再確認
出力:件数、割合、代表例、重大度、改善案
再測定:施策実施から4週間後無料でテキストマイニングを始める方法
表計算ソフトで小さく始める
件数が少ない場合は、ExcelやGoogleスプレッドシートでカテゴリ列を作り、人が分類できます。最初の100〜300件を読むことで、業界固有の分類を作りやすくなります。
Pythonやオープンソースを使う
再現可能な分析が必要なら、Pythonで形態素解析、TF-IDF、分類、可視化を行えます。コード、ライブラリ、辞書、乱数、前処理条件を保存します。担当者が保守できるかも判断します。
生成AIで分類案を作る
匿名化した少量データからカテゴリ案を作り、人が基準を修正します。全件を一度に要約させるより、カテゴリ定義、例、例外、確信度、原文IDを出力させると監査しやすくなります。
無料ツールの注意点
無料だから業務データを入力してよいとは限りません。規約、保存、学習利用、公開設定、ファイル上限を確認します。顧客データは、会社が許可した環境を使います。
テキストマイニングツールの選び方
ノーコード型
現場担当者が頻出語、感情、共起などを画面で確認しやすい反面、独自前処理や再現性の細部に制限があります。データ取込、辞書、CSV出力、権限、サポートを確認します。
BI・VOC統合型
アンケート、コール、CRMなど複数チャネルを統合し、ダッシュボードで運用する用途です。導入費だけでなく、データ接続、分類設計、教育、保守の費用を見ます。
プログラミング型
自由度と再現性は高い一方、実装、検証、セキュリティ、保守が必要です。PoCのコードが属人化しないよう、データ定義と実行環境を文書化します。
| 選定項目 | 確認内容 | 質問例 |
|---|---|---|
| 日本語 | 分かち書き、辞書、否定 | 自社用語を登録できるか |
| データ | CSV、API、CRM、音声 | どの形式と件数に対応するか |
| 分析 | 頻度、共起、感情、分類 | 原文へドリルダウンできるか |
| 運用 | 権限、履歴、再実行 | 条件と結果を保存できるか |
| セキュリティ | 保存、暗号化、削除 | データはどこに残るか |
| 費用 | 初期、月額、従量、支援 | 分析件数増加時にどう変わるか |
生成AIでテキストマイニングする方法
得意なのは分類案と説明
生成AIは、自由記述のカテゴリ候補、代表例、要約、改善仮説を作るのに便利です。一方、同じ入力で分類が変わる、件数を正確に数えない、存在しない引用を作る可能性があります。
原文IDと構造化出力を使う
各文章にIDを付け、カテゴリ、根拠となる短い抜粋、確信度、要確認を表形式で出します。集計は表計算やコードで行い、生成AIに暗算させません。
評価用データを作る
人が正解を付けたサンプルを用意し、一致率、重大な誤分類、未分類を確認します。精度が低いカテゴリは定義を見直し、機微な判断を自動化しません。
マーケティングでの活用例
広告クリエイティブ
口コミから利用場面、期待、不満、表現を抽出し、訴求仮説を作ります。顧客の文章を無断で広告へ転載せず、誇大表現や代表性を確認します。
SEO・AIOコンテンツ
検索語、問い合わせ、営業質問から、読者が比較する条件や不安を整理します。頻出語を詰め込むのではなく、質問へ明確に答え、根拠と一次情報を示します。
商品改善
要望を件数だけでなく、解約や安全への影響、顧客価値、実現難易度で評価します。声の大きさと事業優先度を混同しません。
テキストマイニングの注意点
データの偏り
回答者は顧客全体を代表しないことがあります。投稿しやすい人、極端な体験、特定チャネルへ偏ります。母集団と取得条件を記載します。
少数意見の消失
頻度が低くても、安全、差別、法令、重大な障害に関する声は優先すべき場合があります。自動集計とは別に重大カテゴリを監視します。
相関と因果の混同
ある言葉と解約が同時に多くても、その言葉が原因とは限りません。契約プラン、時期、顧客属性、障害など別要因を確認します。
個人情報と倫理
公開SNSでも、利用規約、研究倫理、プライバシー、再識別の可能性を考慮します。取得できることと、自由に分析・公開できることは同じではありません。
テキストマイニングを始めるためのサンプル設計
分析ツールを開く前に、どの意思決定に使うかを決めます。ここでは、問い合わせとアンケート自由記述から改善課題を見つける例で説明します。
目的と対象を定義する
「顧客の声を分析する」では広すぎます。「直近3カ月の解約理由を分類し、次の四半期に改善する上位3課題を決める」のように、期間、対象、判断を明確にします。
- 対象期間
- 対象チャネル
- 分析単位
- 除外条件
- 最終的に決めたいこと
分析単位は、1人、1回答、1文、1問い合わせなどから選びます。長文を1件として扱うと複数の論点が混ざるため、文や話題単位へ分割する場合があります。
データ項目をそろえる
本文だけでなく、日付、商品、顧客区分、問い合わせ種別、解約有無など、比較に必要な属性を付けます。ただし個人を特定する情報は、目的に不要なら削除・匿名化します。
1. 元データを読み取り専用で保存する 2. 分析用コピーを作る 3. 重複と空欄を確認する 4. 個人情報を削除・置換する 5. 文字コードと表記を統一する
分類辞書を作る方法
自動分類だけに任せると、現場固有の言葉を誤解します。最初に100〜300件程度を人が読み、カテゴリー案を作ります。
カテゴリーの粒度を決める
「不満」という大分類だけでは施策につながりません。一方で細かく分けすぎると件数が少なくなります。例えば「料金」「操作」「速度」「サポート」「機能不足」のように、担当部署が行動できる粒度を目指します。
定義と具体例を残す
各カテゴリーに、含める条件、含めない条件、実際の例文を付けます。
- 料金:高い、値上げ、費用対効果に関する記述
- 操作:画面、手順、分かりにくさに関する記述
- 速度:表示、処理、回答時間に関する記述
- サポート:問い合わせ対応、説明、解決時間に関する記述
- 機能不足:必要機能がない、連携できないという記述
一つの文に複数カテゴリーを付けるか、主カテゴリー一つに絞るかも決めます。
辞書を版管理する
カテゴリーは商品や施策の変化で更新されます。更新日、変更理由、追加・統合した項目を残し、過去データとの比較可能性を保ちます。
分析精度を評価する指標
見た目のきれいなグラフより、分類がどの程度正しいかを確認します。
適合率
あるカテゴリーと判定した中で、実際に正しかった割合です。誤って分類することを減らしたい場合に重視します。
再現率
本来そのカテゴリーに入る文章のうち、見つけられた割合です。重要な苦情を見逃したくない場合に重視します。
一致率
複数の担当者が同じデータを分類し、どの程度一致するかを見ます。人同士で一致しないカテゴリーは、AIでも安定しません。
サンプル確認
- 件数上位カテゴリーから無作為抽出する
- 急増したカテゴリーの原文を読む
- 「その他」に入った文章を確認する
- 否定表現や皮肉を重点確認する
- 短文と長文を分けて見る
頻出語・共起・感情分析の使い分け
各手法が答えられる質問は異なります。
頻出語
多く登場する語を把握します。ただし「商品」「利用」など一般語が上位を占める場合があるため、除外語と同義語の統合が必要です。
共起分析
同じ文や回答で一緒に現れる語を確認します。「価格」と「高い」、「画面」と「分かりにくい」など、論点の組み合わせを見つけます。共起しただけで因果関係があるとは限りません。
感情分析
肯定・否定・中立などの傾向を見ます。日本語の否定、皮肉、業界用語は誤判定しやすいため、スコアが極端な原文を確認します。
トピック分類
大量の文章を話題別にまとめます。カテゴリー名は人が読んで付け、施策担当者が理解できる言葉へ直します。
生成AIを組み合わせるときの役割分担
生成AIは、カテゴリー案、要約、ラベル付け、原文の言い換えに使えます。ただし再現性を保つには、入力と出力を固定します。
向いている作業
- 初期カテゴリー案の作成
- 定義に基づく仮分類
- 各カテゴリーの代表意見の要約
- 類似表現の統合候補
- 施策仮説と追加調査項目の整理
人が確認すべき作業
- 個人情報の取り扱い
- カテゴリー定義
- 誤分類と見逃し
- 少数だが重大な意見
- 施策の優先順位
同じプロンプト、同じモデル、同じ設定でも出力が変わる可能性があります。重要な分類はルールベースや人の確認を組み合わせます。
ダッシュボードに載せる指標
集計結果は、現場が次の行動を決められる形にします。
1. 総件数とデータ取得率 2. カテゴリー別件数と構成比 3. 前週・前月からの増減 4. 顧客区分・商品別の差 5. 重大度の高い意見件数 6. 未分類・その他の割合 7. 改善施策と担当者
件数が増えたときは、顧客数や回答数が増えただけではないかを確認します。構成比と母数を同時に表示してください。
分析から改善施策へつなげる会議
月次報告でグラフを眺めるだけでは、テキストマイニングの価値が出ません。分析会議では次の順で確認します。
事実
どのカテゴリーが何件、どの顧客層で、いつ増えたかを示します。解釈を混ぜません。
原文
代表例だけでなく、反対意見や少数意見も読みます。個人情報は伏せます。
仮説
商品変更、キャンペーン、障害、季節性など、増減の理由候補を出します。未確認事項を分けます。
施策
- FAQや説明文を修正する
- 画面や導線を改善する
- サポート手順を変更する
- 商品機能を検討する
- 追加アンケートを行う
再測定
施策後に同じ定義で再集計し、件数、構成比、関連KPIがどう変わったかを見ます。
よくある失敗と修正方法
ワードクラウドだけで終わる
大きく表示された語が重要とは限りません。顧客区分、時系列、評価、原文と組み合わせます。
全データを一括で混ぜる
商品、顧客、チャネルが異なると傾向が相殺されます。目的に応じてセグメントを分けます。
「その他」が増え続ける
辞書が現状に合っていません。「その他」の上位表現を読み、新カテゴリー追加や既存定義の修正を行います。
AIの要約だけを報告する
要約には少数の重大意見が消えることがあります。件数、代表原文、例外、確認方法をセットで示します。
結果を因果関係として扱う
不満と解約が同時に見えても、直接の原因とは限りません。行動データ、インタビュー、実験で追加確認します。
30日間の導入ロードマップ
1週目:設計
- 対象業務と意思決定を決める
- データソースと利用目的を確認する
- 個人情報・権限を整理する
- 成功指標を決める
2週目:データ整備
- 重複、欠損、表記を整理する
- サンプルを人が読む
- カテゴリー辞書を作る
- 分析用データを匿名化する
3週目:試行分析
- 頻出語、共起、分類を試す
- 人の正解データと比較する
- 誤分類を修正する
- ダッシュボード案を作る
4週目:施策と運用
- 上位課題を3つに絞る
- 担当者と期限を決める
- 再測定日を設定する
- 辞書と手順を文書化する
テキストマイニングは一度の分析ではなく、データ取得、分類、施策、再測定を繰り返す運用です。
業界別の活用例
EC・小売
商品レビュー、返品理由、チャット問い合わせを統合し、商品、配送、梱包、説明、サイズに分類します。レビュー件数だけでなく、返品率、再購入率、商品別売上と組み合わせます。
SaaS・ITサービス
サポートチケット、解約アンケート、商談記録を分析し、機能不足、操作、障害、価格、導入支援に分類します。契約プランや利用期間で分けると、初心者の課題と長期利用者の課題を区別できます。
飲食・店舗
口コミ、予約サイト、アンケートを、味、接客、待ち時間、清潔さ、価格、アクセスに分類します。店舗別・時間帯別に見ますが、少数の投稿から従業員個人を断定しないようにします。
人事・組織
従業員アンケートや面談記録を分析する場合、匿名性と利用目的を明確にします。少人数部署の結果を公開すると個人が推測される恐れがあるため、集計単位と閲覧権限を制限します。
自治体・公共
住民意見やパブリックコメントをテーマ別に整理できます。多数意見だけでなく、少数でも安全や権利に関わる意見を別枠で確認します。
無料ツールと有料ツールの判断
無料ツールは、小規模なサンプルで手法を理解するのに向きます。有料ツールは、大量データ、複数人利用、辞書管理、権限、API、定期実行、サポートが必要な場合に検討します。
無料で試しやすい条件
- データ件数が少ない
- 個人情報を除去できる
- 単発の分析である
- 手動で原文確認できる
- 結果を社内の参考情報として使う
有料化を検討する条件
- 毎月・毎週繰り返す
- 複数チャネルを統合する
- 部門ごとの権限が必要
- 分類辞書を共有・版管理したい
- BIやCRMへ連携したい
- 監査ログやサポートが必要
分析レポートのテンプレート
1. 目的
何を判断するための分析かを一文で書きます。
2. 対象データ
期間、チャネル、件数、取得率、除外条件を示します。
3. 方法
分析単位、前処理、辞書、使用ツール、人の確認方法を記載します。
4. 結果
カテゴリー別件数、構成比、時系列、セグメント差を示します。
5. 原文例
個人情報を除去した代表例と例外を掲載します。
6. 解釈と限界
何が言えて、何は言えないかを分けます。回答者の偏りや取得漏れも書きます。
7. 次の施策
担当者、期限、期待指標、再測定日を決めます。
データ品質を保つ運用ルール
入力元で項目名や選択肢が変わると、時系列比較が崩れます。フォームや問い合わせシステムの変更を分析担当者へ共有し、データ辞書を更新します。
- 項目名と定義を記録する
- 選択肢の変更日を残す
- 欠損理由を区別する
- 重複判定ルールを固定する
- タイムゾーンと日付形式を統一する
- 削除・匿名化の履歴を残す
小さく始めるための最初の100件
最初から全データを投入せず、直近100件を人が読みます。頻出する論点、少数だが重大な論点、判断しにくい表現をメモし、5〜10個のカテゴリーを作ります。
次に別の100件へ同じ辞書を適用し、分類できない文章と誤分類を確認します。辞書を修正したら、最初の100件にも戻って一貫性を確認します。この反復で、現場に合う分類へ近づけます。
結果を公開するときの注意
顧客の声をそのまま引用すると、個人や企業が特定される場合があります。引用許可、匿名化、文脈、少数データの扱いを確認します。否定的な意見だけを選んで結論を強めたり、都合のよい期間だけを使ったりしないようにします。
分析結果は「顧客全体の意見」と断定せず、対象期間、回答者、取得チャネルの範囲で表現してください。
アンケート設計から改善する
自由記述の質問が曖昧だと、分析しても施策につながりません。「ご意見をお聞かせください」だけでなく、「利用開始時に分かりにくかった点」「解約を決めた最大の理由」など、判断したい内容に合わせます。
- 一つの質問で複数の論点を聞かない
- 誘導的な表現を避ける
- 任意回答か必須回答かを明示する
- 利用目的と匿名性を伝える
- 選択式と自由記述を組み合わせる
回答しなかった人の傾向も結果へ影響します。回答率と取得経路を併記します。
時系列比較の注意点
月ごとの件数を比較するときは、総回答数、顧客数、キャンペーン、障害、質問変更を確認します。分類辞書を更新した場合は、過去データを新しい定義で再分類するか、変更前後を分けて表示します。
季節性がある業務は前月比だけでなく前年同月比も見ます。急増を見つけたら、数値だけで結論を出さず、該当期間の原文を読んでください。
分析担当者の役割分担
業務担当者はカテゴリーと施策を決め、データ担当者は取得・整形・集計を担い、情報管理担当者は個人情報と権限を確認します。経営・責任者は優先順位と投資判断を行います。
一人で兼務する場合も、これらの役割をチェックリスト上で分けると、分析者の解釈だけで施策が決まることを防げます。
成果を判断する基準
分析レポートを作った件数ではなく、課題発見から改善までの時間、改善施策の実行率、関連する問い合わせ・解約・満足度の変化を見ます。変化がなくても、仮説が誤っていたのか、施策が実行されなかったのか、測定期間が短いのかを切り分けます。
テキストマイニング単独の効果と断定せず、同時期の価格変更、広告、障害、季節性も記録してください。
分析条件と限界を毎回残すことで、次回の比較精度も上がります。
よくある質問
テキストマイニングを簡単に言うと何ですか?
大量の文章から、よく出る話題、言葉の関係、感情、変化を整理し、改善や判断に使う方法です。
無料でできますか?
少量なら表計算、Python、無料枠などで試せます。業務データを外部サービスへ入力する前に、規約と社内ルールを確認してください。
ChatGPTだけで分析できますか?
分類案や要約には使えますが、正確な集計、再現性、個人情報保護、原文確認が必要です。表計算やコードと組み合わせます。
感情分析は正確ですか?
皮肉、否定、専門用語、文脈で誤りが起きます。自社データのサンプルを人が確認し、用途に必要な精度を評価します。
何件あれば分析できますか?
目的とばらつきによります。少量でも内容把握はできますが、割合の比較やモデル評価には十分な件数と代表性が必要です。
ワードクラウドだけで分析できますか?
全体像を見る入口にはなりますが、文脈、否定、属性、時系列が分かりません。原文、カテゴリ、件数、割合と組み合わせます。
参考資料と関連記事
- Google Developers:Text Classification Guide
- Google Developers:データの探索
- Google Developers:データ準備
- NIST:AI Risk Management Framework
- 総務省:AI事業者ガイドライン
- AIマーケティングツール比較
- AIマーケティングとは
- ChatGPTプロンプトとマーケティング
- 生成AI無料ツールおすすめ8選
- AIO対策で一次情報を作る方法
競合記事の見出しや文章を転載せず、公式情報と当メディアの監査基準をもとに独自構成で制作しています。未検証の効果や安全性は保証しません。
監修者プロフィール
魚見幸司
生まれ(32歳)
テキストマイニングを可視化で終わらせず、目的、匿名化、原文確認、施策、再測定までつなげる実務手順として監修しました。
SEO、Web広告、SNS・LINE運用、LP制作・改善、アクセス解析、コンテンツマーケティング、生成AI導入を横断するデジタルマーケティングの専門家。広告代理店で最年少マーケティング事業部長を務め、グローバルマーケティング会社のCMOを経験しています。
成果指標から施策を逆算し、小規模検証から標準化へ進める方法と、人の確認を残した半自動化を重視。SEO・広告・SNS・LP・問い合わせを分断せず、事業成果までつなげる実務検証を行っています。
この記事の監修:本文の手順は分析設計例です。個人情報、利用規約、データの偏りを確認し、重要な判断は原文と人の確認を組み合わせてください。
監修方針:実務で再現できる条件、数値、リスク、確認手順を重視して内容を確認しています。 監修者・専門家情報を見る